Download raw (2.1 KB)
# -*- coding: utf-8 -*-
#!/usr/bin/env python

import csv
import pygraphviz as pgv

CSVPATH = 'datas/csv/beyond-the-first-decade_datas_2006-2015.csv'

def unicode_csv_reader(unicode_csv_data, dialect=csv.excel, **kwargs):
    # csv.py doesn't do Unicode; encode temporarily as UTF-8:
    csv_reader = csv.DictReader(utf_8_encoder(unicode_csv_data),
                            dialect=dialect, **kwargs)
    for row in csv_reader:
        # decode UTF-8 back to Unicode, cell by cell:
        yield [unicode(cell, 'utf-8') for cell in row]

def utf_8_encoder(unicode_csv_data):
    for line in unicode_csv_data:
        yield line.encode('utf-8')


with open(CSVPATH, 'rb') as csvfile:
    lgmreader = csv.DictReader(csvfile, delimiter=',', quotechar='"')
    year_projects = pgv.AGraph(directed=False)
    people_projects = pgv.AGraph(directed=False)

    for row in lgmreader:
        year = unicode(row['year'], 'utf-8')
        title = unicode(row['title'], 'utf-8')
        speakers = unicode(row['speaker'], 'utf-8').split(',')
        projects = unicode(row['project'], 'utf-8').split(',')

        if year and title:
            year_projects.add_node(year)
            #graph.add_node(title)

            #graph.add_edge(year, title)


            for project in projects:
                if project:
                    year_projects.add_node(project.strip())
                    year_projects.add_edge(year, project.strip())

                    people_projects.add_node(project.strip())

                    for speaker in speakers:
                        if speaker.strip():
                            speaker_text = speaker.encode('utf-8')
                            people_projects.add_node(speaker.strip())
                            people_projects.add_edge(project, speaker)

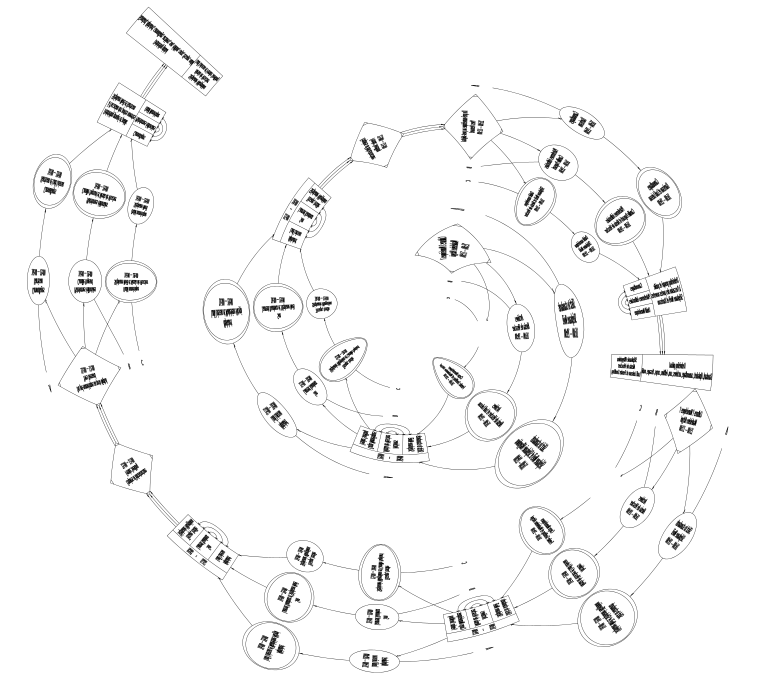
    year_projects.write('a_decade_of_projects.dot')
    people_projects.write('a_decade_of_people_and_their_projects.dot')

    year_projects.draw('a_decade_of_projects.png', 'png', 'fdp')
    people_projects.draw('a_decade_of_people_and_their_projects.png', 'png', 'fdp')